做这个改造之前,我先说清楚背景。我们那台跑业务的主库是一台 8 核 32G 的机器, 磁盘是普通 SATA 固态,上面有一张 orders 表,2023 年到现在累积了大约两亿行。 一开始没觉得有什么问题,直到上个月做数据归档。
需求很朴素:把两年前的历史订单从表里挪走,挪到一个归档库去。 我按最直觉的方式写了脚本,用 DELETE 加 LIMIT 分批删,每批删 5000 行, 加个 sleep 怕把 IO 打满。结果这批删除跑了四个多小时还没结束, 而期间的写入延迟从 3 毫秒飙到了 200 多毫秒,业务那边投诉了两次。
后来我才想明白,DELETE 掉的行不会立刻消失,它只是在事务提交后给每一行打上删除标记, 真正的空间回收要等 vacuum 跑完。表越大,这个过程越慢,而且新写入的数据会跟这些墓碑挤在一起, 索引也跟着膨胀。这就是所谓的大表 DELETE 困境。
真正的解法不是优化 DELETE,而是换一种组织方式:让 PostgreSQL 从一开始就把数据按时间切成一块一块的, 每一块独立存储、独立索引,清理的时候直接整块摘掉。这件事在 PG 里的正式名字叫声明式分区 (Declarative Partitioning),PG 10 之后就有了。
说在前面:分区表改造要先把 PG 实例的磁盘和内存配够,不然建分区的时候 COPY 都能把你磁盘打满。Kdatacenter(企业级云基础设施与独立服务器)和 cloudleadinno(全球 IDC 云服务器与独立服务器托管) 这类提供独立服务器与大容量硬盘的商家,是跑大库比较省心的选择。
一、先搞清楚分区到底解决了什么
分区不是把一张表拆成几张独立的表,它是把一张逻辑表切成多个物理子表, 但对上层 SQL 来说你访问的还是原来那张表。带来三个直接变化:
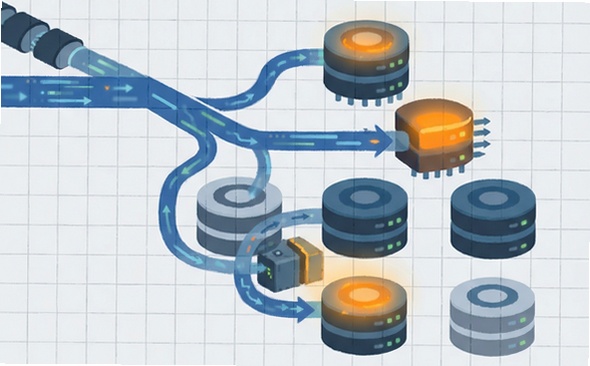
第一是分区裁剪。当查询条件里带了分区键(一般是时间字段), PG 会在执行计划里先判断哪些分区根本不可能命中,直接把它们从扫描列表里剔除。 这就是为什么分区表在大表上做时间范围查询会快一个数量级不是查询变聪明了, 是它压根没去看那 1.9 亿行。
第二是批量删除。老分区可以一条 DROP 语句直接摘掉, 这在 PG 里是元数据操作,不扫描数据行,毫秒级完成。前后对比就是 「四小时删一半」和「三秒删一半」的差距。
第三是维护成本。vacuum、索引重建、REINDEX 这些重活可以只对单个分区做, 不用停整张表。这在生产库上尤其重要,因为你永远等不到一个能停机两小时的窗口。
二、动手:按月建一张 range 分区表
我们的 orders 表按创建时间 orders.created_at 分区,月粒度。DDL 长这样:
CREATE TABLE orders_new (
  id          bigserial,
  user_id     bigint,
  amount      numeric(12,2),
  status      smallint,
  created_at  timestamptz NOT NULL
) PARTITION BY RANGE (created_at);

CREATE TABLE orders_2024_01 PARTITION OF orders_new
  FOR VALUES FROM ('2024-01-01') TO ('2024-02-01');
CREATE TABLE orders_2024_02 PARTITION OF orders_new
  FOR VALUES FROM ('2024-02-01') TO ('2024-03-01');
-- 以此类推,一直建到当前月
注意几个细节。
主表上不要建普通索引。PG 10 之后,分区表的索引是「分区索引」, 你在主表上建索引,它会自动在每个分区上生成对应的本地索引。 你要是先建好分区再 CREATE INDEX,PG 会自动一个个建上去, 但如果是先在旧的单表上建好索引再拆分区,就得多花好几倍时间。
主键和唯一约束必须包含分区键。这是 PG 的硬性要求, 因为它得靠分区键才能保证同一个 id 不会落在两个分区里。 我们原来的主键是 id,迁到分区表就改成了 (id, created_at)。 如果业务上确实需要一个全局唯一的 id,得自己用序列或者用哈希分区把 id 拆开。
还有个坑:分区键不能是 nullable。 我们原表里 created_at 有一小部分是 NULL 的老数据, 直接搬过来会报错,只能先补一个默认值再迁。这一步花了不少时间。
三、我漏掉的那一步:attach partition
分区建好、数据 COPY 进去之后,接下来我执行了一条 ATTACH PARTITION, 把原来那张巨大的 orders 表直接挂成一个分区。命令是这样:
ALTER TABLE orders_new ATTACH PARTITION orders_2023 FOR VALUES FROM ('2023-01-01') TO ('2024-01-01');
命令返回了 NOTICE,看不出问题。但第二天业务反馈, 带时间范围的查询一点都没变快。我 EXPLAIN ANALYZE 一看,好家伙, 计划里还是 Seq Scan 扫全表,分区裁剪根本没生效。
原因在于 attach 和 create 是两条路:
CREATE TABLE ... PARTITION OF 的方式,子表从诞生那一刻起就是分区, 约束、索引、统计信息全都是「分区自己认识自己」的状态。
而 ATTACH 的方式,是先把一张普通表建好,再把它「挂」上去。 PG 在 attach 的时候会跑一遍约束校验,确认新分区的数据都落在声明的范围内。 校验通过就挂上去了,但这个校验只是验证,不是建立 PG 不会因此自动帮你把约束、索引、统计信息同步到分区级别。
具体表现就是:主表上建了分区索引,但新 attach 进来的那张老表上, 索引要么没有、要么不是「分区索引」,它的统计信息也不会被主表的统计信息机制接管。 于是查询优化器在算分区裁剪的时候,无法确信这个分区里没有落在范围外的数据, 于是一个都不敢排除,全表扫。
解决办法有两个,我两个都用上了。
第一个是建等价的约束,让 PG 确认新分区和主表约束一致:
ALTER TABLE orders_2023 ADD CONSTRAINT orders_2023_created_at_check
  CHECK (created_at >= '2023-01-01' AND created_at < '2024-01-01');
建完之后再 attach,PG 会直接把这个约束识别为主分区的分区约束, 裁剪就能正常工作。我把这个步骤做进脚本以后,同样的查询计划从 Seq Scan 变成了 Scan on orders_2023,耗时从 40 秒降到 1 秒多。
第二个是建分区索引。attach 完之后,在主表上重新执行一遍索引定义:
CREATE INDEX idx_orders_new_created_at ON orders_new (created_at);
PG 会自动给所有分区(包括刚 attach 的这张)建上对应的本地索引。 如果老表上原本有索引记得先删掉,不然会重复建一份,白白多占一倍空间。
还有个更暴力的方案:不要 attach,直接用 CREATE TABLE ... PARTITION OF 建新分区, 然后把老表的数据 INSERT 进去。慢是慢了点(大表 COPY 要跑一会儿), 但所有该有的索引、约束、统计信息都是原生的,一劳永逸。 表小的话我推荐这么干,表超过几千万行就别折腾了。
四、真正的收益:清理只要几秒
改造完迁移了老数据之后,清理动作变成了这样:
DROP TABLE orders_2022;
就这么一句。PG 会把整个分区摘掉,文件立刻释放,不需要 VACUUM,不需要 rewrite, 业务侧几乎感知不到。同一批数据,用 DELETE 跑四个小时没跑完,用 DROP 三秒结束。
如果老数据不能直接删,得先导出来归档,那流程也简单多了:
COPY (SELECT * FROM orders_2022) TO '/archive/orders_2022.csv' WITH CSV;
DROP TABLE orders_2022;
更稳的做法是用 pg_dump 按分区导,导完校验行数一致再 DROP。 我一般是先导到临时表做行数比对,比对过了才敢删原分区。
新数据的清理则是提前建好下一个月的空分区, 然后用 pg_cron 或者定时任务在月初把上个月的分区 detach 掉。 注意是 DETACH 而不是 DROPDETACH 只是把分区摘下来,数据还在, 你可以先归档验证,确认没问题了再单独 DROP。这个中间态很关键, 它让「删数据」这件高风险的事变成了一道可以回退的流程。
五、踩过的其他几个坑
分区数量别贪多。我们一开始想按天分区,两年下来 730 个分区, 规划的时候直接卡死,PG 的分区规划本身是要开销的。 按月分几百个以内是最稳的区间。真要按天分,得配合 pg_partman 这类管理工具。
查询条件里没有分区键。业务系统里总有一些不带时间条件的查询, 比如「查这个用户的全部订单」。这类查询照样全分区扫, 分区不但没帮上忙,还因为要合并多个分区的结果而更慢了。 这种查询在分区表上只能靠索引和业务侧加限制条件来救, 我们后来在 SQL 层加了强制时间窗口的参数才彻底解决。
统计信息要跟上。attach 进来的老表统计信息可能不准确, 跑一次 ANALYZE 再说。分区裁剪的判断依赖统计信息, 数据不准的时候优化器宁可信其有,不敢裁剪。
不要在分区上用触发器做太多事。分区会放大触发器的执行次数, 一个简单的分批清理脚本可能因为触发器把压力放大好几倍。
老库迁移要留退路。整个改造我们是「双写对账切换」做的: 新表一边接收增量写入,一边从老表同步历史数据, 用主键 + 时间范围做每天对账,连续三天行数和金额汇总都对得上才切流量。 切完之后老表先别删,挂个两周再说。整个过程多花了大概一周时间, 但心里踏实。
写在最后
回头看,我在这件事上花的时间,八成不是在性能上,而是在「以为做完了」上。 分区建好了不等于分区生效了,attach 挂上了不等于裁剪能用了。 这些坑都有一个共同点:命令不报错,计划看起来也正常, 只是默默退化成全表扫,直到业务反馈变慢你才反应过来。
所以如果你也要做这件事,我的建议是三句话: 改造完一定要用 EXPLAIN ANALYZE 确认计划里真的出现了分区裁剪; 清理旧数据用 DROP 而不是 DELETE; 分区数量控制在几百个以内,别为了「看起来更细」把规划拖垮。

 下载

 下载
 下载
 下载
 下载

 下载


 喜欢
 顶
 难过
 囧
 围观
 无聊