

先说一个我踩过的坑:去年有天上午,一个同学在后台误删了一批用户数据,运营那边同时在群里问「这批数据能恢复到昨天吗」。我第一反应是去点云盘快照,翻到控制台一看当天凌晨两点有一份自动快照,点进去,恢复。数据回来了,但回到的位置是凌晨两点,而不是昨天中午。中间那十个小时的数据,没了。那天我才真正搞明白,云盘快照和「备份」不是一回事,它更像是一台每隔一段时间自动按一次快门的相机,按下快门那一刻的世界被完整保留下来,镜头之外的一切它都不知道。
如果你现在正打算给服务器配备份策略,下面这两个是拿来直接对比着用的:狗云DOGYUN(高性价比云服务器,云盘快照与自动备份开关齐全,适合拿来练手这套流程)、RackNerd(海外 VPS 节点多,适合多机房做异地副本的场景)。机器本身不用多贵,关键是磁盘数据得能被完整恢复。
一、坑一:保留期默认是短的,短到你以为它一直在
大多数云厂商的自动快照,默认策略是「保留最近 7 份」或者「每 4 小时一份、保留 24 小时」。7 份这个数字听起来很多,但如果你的业务一天会做十几次数据变更,7 份快照可能只覆盖大半天。我那次误删之所以只救回凌晨两点,正是因为四小时一份的节奏加上 24 小时保留,实际能选的最远一份就是凌晨那份。
这里有个反直觉的地方:如果你把保留份数从 7 调到 30,看起来是安全了,但真正的风险是这 30 份快照全部躺在同一块云盘上。勒索软件或者误执行的加密脚本一旦扫到云盘 API,它一样能把这些快照一起删掉。我在控制台看到过一个客户案例,运维为了「释放空间」手工清了快照,两周后数据库出故障,才发现所谓的「每天都有备份」只剩下一份,还是在攻击者手里。
所以保留期这一项,我现在的做法是分两层:短周期快照保留期拉到 7 天甚至 30 天,作用是「应对误操作快速回滚」;长周期备份另走一套,走对象存储或者另一台机器,作用是「应对整机级灾难」。这两件事不能混为一谈,快照解决不了跨地域的问题,也解决不了「快照本身被删」的问题。

二、坑二:所有副本都在同一个城市,等于没有异地容灾
第二条更隐蔽。很多人在同一台云厂商的同一个区域开了快照,看着面板上「跨可用区可用」「已开启多副本」,心里踏实了。但跨可用区和跨地域是两回事:跨可用区解决的是单机架掉电这种硬件故障,跨地域解决的才是整个区域级的灾难,比如某个区域的机房整体故障、或者那条线路被掐了。
判断标准很简单:把你的备份放在另一个城市,关掉当前城市的所有电源,它还能不能救你。我的做法是,主机房在本地城市的云厂商,异地副本直接推到另一家厂商的对象存储上。数据传输量最大的那次是 200 多 GB,走公网专线传了一整夜,成本比想象中低因为增量之后每天只需要传几百 MB。
但这里要注意一致性问题。跨地域同步不是实时镜像,通常是定时任务拉取的,延迟从几分钟到一小时不等。所以异地副本适合当「最后一道防线」,不适合当「日常回滚点」。日常回滚还是靠本地快照,快照恢复是分钟级的,异地副本恢复是小时级甚至天级的。这两个速度对应两种不同的应急场景,混用会要命。

三、坑三:一致性,数据库恢复出来的表就是空的
这个坑最贵。我有一次帮客户做恢复演练,快照是凌晨 3 点做的,数据库当时正在跑批量写入任务。用这个快照恢复出来的库,表结构在,但里面有几张表是空的因为那批写入任务是在快照点之后才提交的事务。我以为只要把 binlog 补上就万无一失,结果发现快照和 binlog 之间的 WAL 序号对不上,中间隔了大概三十秒。
根因是:云盘快照是应用一致性还是崩溃一致性,取决于你用的是文件系统级的自动快照,还是在应用层做的快照(数据库自己 flush 并冻结日志点)。前者拍下来的是「某一瞬间操作系统看到的所有数据块」,可能正好卡在 MySQL 正在写 redo log 的中间;后者拍的是「数据库自己声明的安全点」。
所以我的建议是:数据库一定要用应用层的一致性方案MySQL 用 XtraBackup 或者自己写脚本调 `FLUSH TABLES WITH READ LOCK` 再打快照,PostgreSQL 用 pg_basebackup 配 wal archiving。文件、静态资源、日志这类随便用云盘自动快照就行。
还有一件事:快照恢复出来的是数据,不是配置。系统盘里的 my.cnf、crontab、systemd 服务、证书私钥,这些都要单独管理。我见过一个团队数据恢复成功了,跑起来发现定时任务全没了,因为那些东西只存在于正在运行的机器的 crontab 里,从来没进过任何备份策略。

四、我现在的备份策略长什么样
把上面几个坑串起来,我最后落到纸面上的是这样一个结构,我按层说。
第一层,小时级快门:云盘自动快照,每小时一次,保留 7 天。作用是快速回滚。误删、误改配置、程序写坏数据这种日常事故,从发现到恢复控制在十分钟以内。这一层最简单,也最容易被当成「我已经有备份了」的错觉来源。
第二层,日级全量 + 周级归档:应用层一致性备份,写到对象存储。用 XtraBackup 或 pg_basebackup 出全量包,异机传到对象存储桶里,配生命周期规则保留 90 天。这一层能扛住「整机没了」「云盘被格式化」「账号被锁」这类灾难。恢复慢,但恢复出来是可信的。
第三层,异地副本:跨厂商对象存储同步,保留 180 天。只同步第二层的数据,一天一次。作用是兜底。
第四层,恢复演练:每月一次,全流程走一遍。这一层是我最想强调的,也是最容易被跳过的。备份不是「文件存在」,是「文件能被恢复出来并且能用」。演练时故意在一台测试机上恢复一份三个月前的备份,把服务拉起来,跑一遍核心接口,确认能返回正确数据。这一步花的时间是每次 2 小时左右,但它是唯一能证明你前面三层真的有效的办法。
第五层,配置留档:systemd、crontab、证书、密钥分离管理。配置和代码进 Git,敏感信息单独放,配一台跳板机做权限收敛。
如果只让我保留一条,那就是第四层。没有演练过的备份,只能叫「文件」,不能叫「备份」。
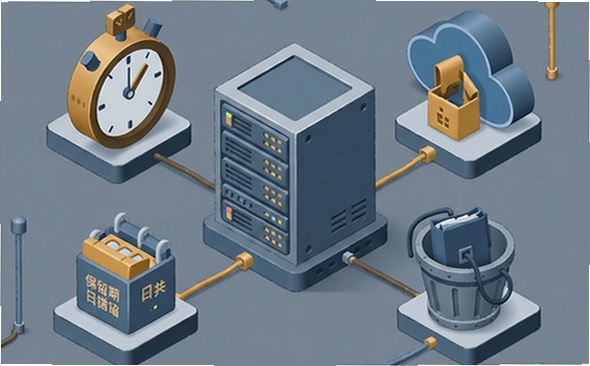
五、几个容易被忽略的细节
备份任务本身要监控。备份脚本失败一次不会有人通知你,它就静静地失败,然后连续失败一周,直到需要用的时候才发现最近的成功记录是七天前。我们的做法是把备份任务的成功状态做成一个 Prometheus 指标,失败就告警推到值班群。
别让备份占满磁盘。备份任务写在自己的临时盘上,写满了就把源数据盘的剩余空间挤成零,然后整台机器挂掉。这种事我见过一次,排查了半天才发现是备份文件没清理。
跨地域传输要限速。异地同步跑满带宽会把线上业务挤死,加个 `pv` 或者工具自带的限速参数,让备份让路。
保留策略要跟着合规要求走,不是跟着磁盘容量走。很多默认策略是「保留 N 份」,但合规要的可能是「保留 180 天内全部版本」,这两件事经常对不上,得提前确认清楚,不然等到审计的时候才发现快照已经滚没了。
回过头看,我那次误删真正花掉的不是 10 个小时的数据,而是大半个通宵的排查和复盘。服务器层面的备份工具再花哨,配置不对就是一堆躺在对象存储里的文件。真正管用的从来不是「我配了快照」这句话,而是「我知道我的数据在什么时间点、在哪个地方、能不能在三小时内拿回来」。

 下载

 下载

 下载
 下载

 下载
 下载

 喜欢
 顶
 难过
 囧
 围观
 无聊




