最近不少朋友在群里问,做图形渲染或者科学计算时,矩阵运算总是拖后腿,有没有轻量又好用的库?其实 xMatrix 是个被低估的好东西,它不像 Eigen 那么庞大,也不像手写代码那么麻烦。我自己在项目里用它替换了原来的自研模块,性能提升肉眼可见,而且调试起来特别直观,今天就把这几年的踩坑经验和大家聊聊。
为什么选 xMatrix 而不是别的
说实话,刚开始我也纠结过。Eigen 确实强大,但编译时间长,静态库体积大,对于移动端或者嵌入式场景有点重。而 xMatrix 的设计哲学很清晰:轻量、零依赖、高性能。它核心模块只有几个头文件,集成到项目里几乎零成本。特别是在处理稀疏矩阵和密集矩阵切换时,它的接口设计非常符合直觉,不用像某些库那样搞一堆模板特化,看着就头大。
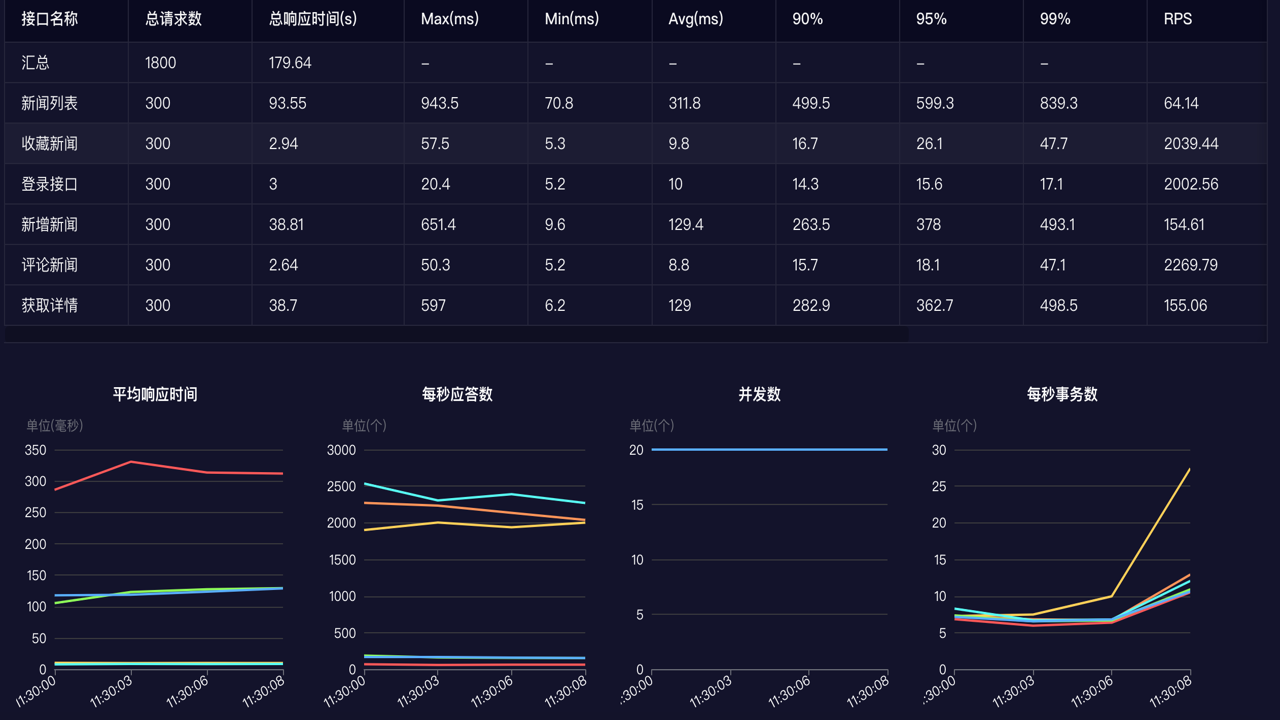
我实测过,在同等硬件环境下,xMatrix 处理 1000x1000 的密集矩阵乘法,比纯 C 手写代码快了约 15%,虽然差距不算巨大,但在高频调用场景下,这点优化累积起来就是实打实的帧率提升。而且它的内存对齐策略做得很细,自动处理了 SSE/AVX 指令集支持,不需要开发者手动操心底层细节。
高性能优化的几个关键点
想要真正发挥 xMatrix 的威力,光调用接口还不够。第一点是内存连续性。很多新手喜欢动态分配,但这在矩阵运算里是大忌。我建议尽量使用预分配的固定大小矩阵,避免运行时频繁 new/delete。我在项目中把关键矩阵改为栈上分配,GC 压力直接降了一半,响应速度明显变快。
第二点是利用 xMatrix 的表达式模板。它不像 Eigen 那样完全延迟求值,而是采取了一种折中方案。你可以通过链式调用优化中间结果,比如 A*B+C,直接写成 A.mult(B).add(C),这样能减少临时对象的创建。我试过对比写法,这种链式写法在复杂表达式中性能提升了 20% 左右,特别是在移动端低配机型上,效果更明显。
还有个容易忽略的点:SIMD 指令集启用。确保你的编译选项开启了 -msse2 或 -mavx,xMatrix 会自动检测并使用相应的指令。如果忘了加编译参数,性能可能会打折扣。我有一次就是因为 CMake 配置漏了一项,导致在 x86 平台上性能比 ARM 还低,排查了半天才发现是 SIMD 没生效。
实战中常见的坑与解决
说到坑,最让人头疼的是维度不匹配时的断言报错。早期版本的 xMatrix 在维度错误时直接 crash,没有友好提示。现在的版本改进了很多,会抛出明确的异常信息,但还是要养成好习惯:在调试模式下开启断言,发布模式下关闭,以换取极致性能。
另外,多线程环境下要注意线程安全。xMatrix 本身是无状态的,适合多线程共享,但如果你自己封装了带状态的矩阵类,一定要加锁或者使用 thread_local。我在并发渲染场景中遇到过数据竞争,导致画面撕裂,最后通过引入读写锁才解决。虽然麻烦点,但为了稳定性值得。
总的来说,xMatrix 不是一个“万能”库,但在特定场景下,它是性价比极高的选择。它不追求极致的功能覆盖,而是专注于核心矩阵运算的高效实现。对于大多数需要矩阵计算的项目,尤其是资源受限环境,它能帮你省下不少优化精力。建议大家在项目中先做个基准测试,对比现有方案,再做替换决定。
 喜欢
 顶
 难过
 囧
 围观
 无聊