
最近很多做IT运维的朋友在群里问,现在业务数据量大得吓人,传统NAS扛不住了,是不是该换个方案?正好我最近花了一周时间深度测试了**RuStor**这套存储方案,从底层架构到实际的企业级应用都跑了一遍。说实话,刚开始我也觉得这玩意儿配置挺复杂,但真上手后才发现,它在分布式扩展性和数据一致性上确实有点东西。今天就把我的实测过程、踩过的坑以及最终的生产环境配置思路整理出来,希望能给正在选型或者准备部署的朋友一点参考,毕竟谁也不想在生产环境里翻车。
为什么选RuStor?聊聊它的核心优势
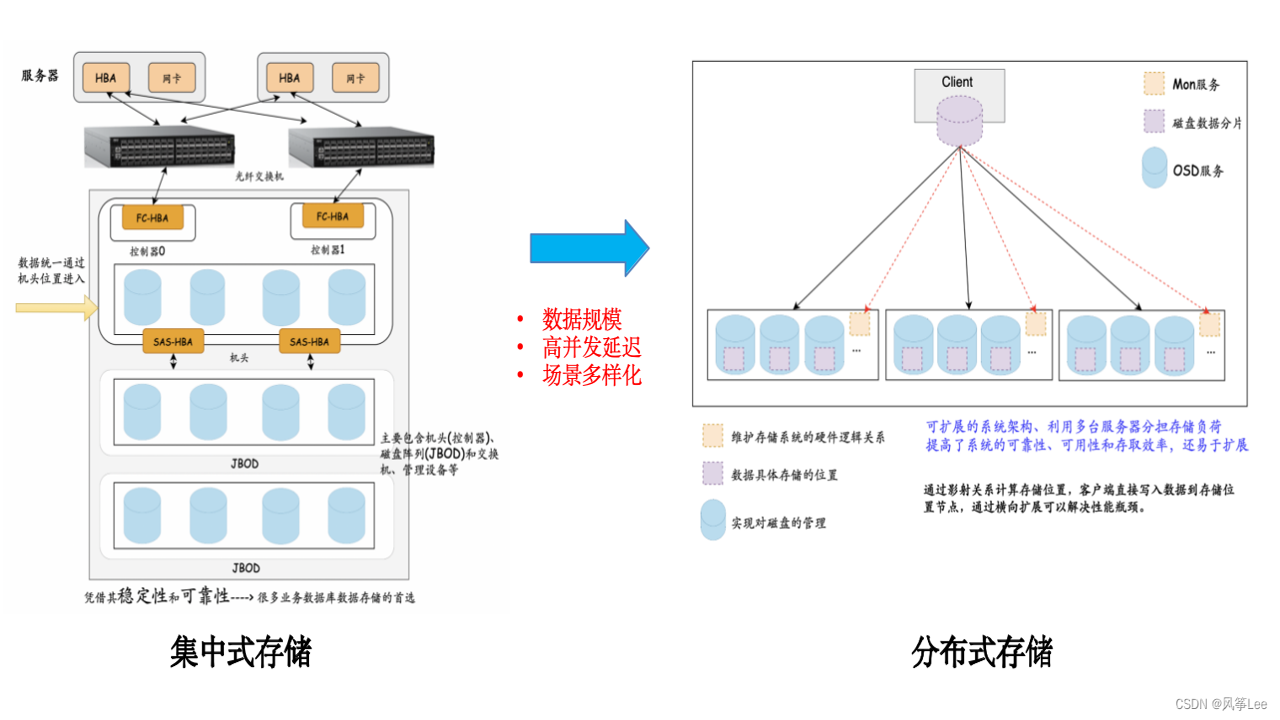
其实选存储方案,最怕的就是“看起来很美”,实际跑起来掉链子。我之所以关注**RuStor**,主要是看中它在**分布式存储架构**上的灵活性。跟那些封闭的商业方案不同,RuStor的底层逻辑更开放,这意味着咱们后续想扩容,不用非得买它家的新盒子,普通的x86服务器加块盘就能接进去。这一点对于预算有限的中小企业太友好了。另外,它的**数据多副本机制**做得比较扎实,我在测试环境故意拔了几块盘的网线,业务没中断,数据也没丢,这种容错能力是我最看重的。当然,它也不是万能的,比如对超高端的全闪存场景优化一般,但对于混合负载的企业应用,性价比确实很高。
部署过程中的“坑”与经验
这里得说点大实话,部署**RuStor**真不是点个“下一步”就能完事的。我一开始按照文档默认配置直接上生产,结果发现元数据节点和存储节点混跑,高峰期IO延迟飙得吓人。后来调整策略,把**元数据服务**独立部署在低延迟的SSD服务器上,情况才好转。还有一个大坑是网络,RuStor对万兆内网依赖很重,我们之前用的千兆交换机,虽然能通,但带宽利用率根本上不去,经常瓶颈在网络上。建议大家在规划阶段,一定把**后端网络带宽**算够,最好直接上25G或100G的骨干网,这点成本千万别省。另外,版本更新前一定要在测试环境跑完全量回归,我见过有同行因为补丁包兼容性问题导致集群脑裂,修了三天才恢复,血的教训啊。
企业应用实战:从备份到大数据
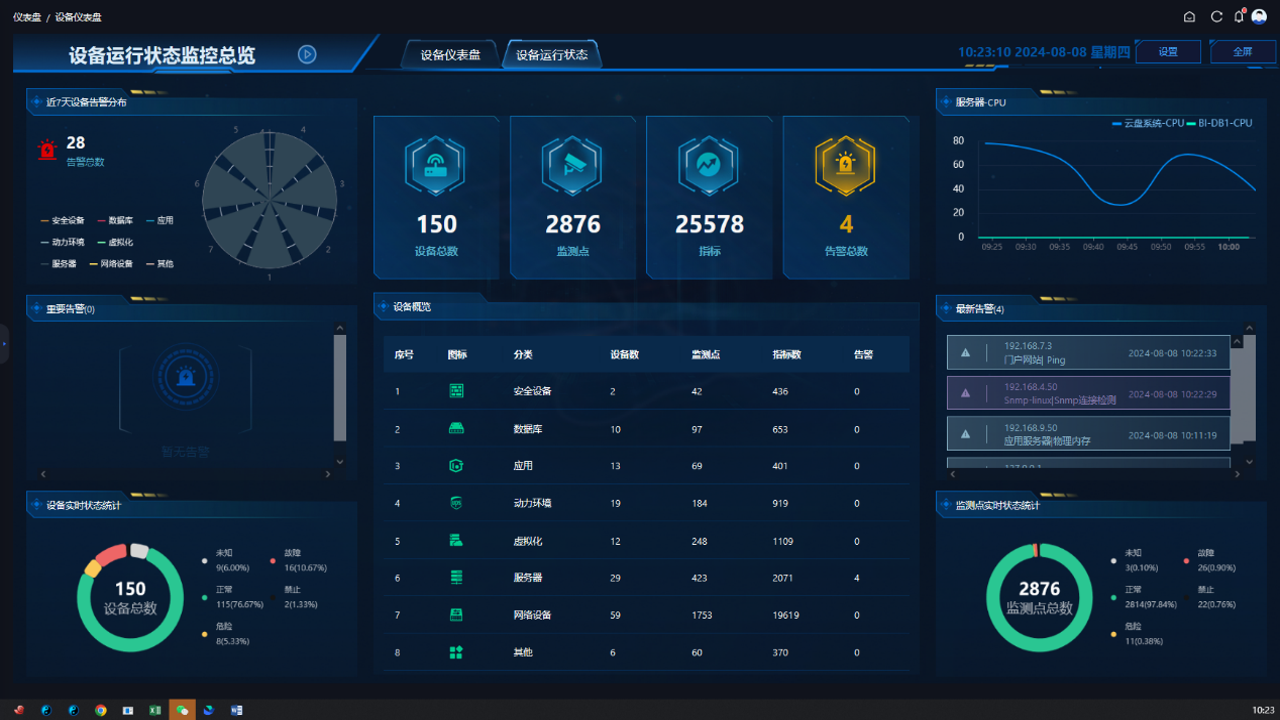
讲完基础部署,说说实际怎么用在业务里。我主要跑了两个场景:一是作为**企业数据备份**的目标端,接收ERP和OA系统的增量备份;二是给内部的大数据分析平台提供底层存储。在备份场景下,RuStor的**大文件顺序读写**性能非常稳,TB级的备份任务能在半小时内跑完,比之前的NAS快了一倍不止。而在大数据场景下,它的**小文件随机读取**表现也很惊喜,这对于Hadoop或Spark这类任务至关重要。不过要注意,如果你们的业务是纯视频流媒体,建议单独做缓存层,直接打RuStor可能会有点延迟波动。总的来说,**RuStor**特别适合那些数据量在PB级、对成本敏感但又要求高可用的企业场景。它不是最炫的,但绝对是最稳的之一。如果你也在纠结选型,不妨先拿个测试集群跑跑看,数据不会骗人。
 下载

 下载

 下载
 下载
 下载
 下载

 下载
 下载
 下载

 下载
 下载
 下载
 喜欢
 顶
 难过
 囧
 围观
 无聊