最近好多朋友在后台问我,说最近听同行提起一个叫Mungdax的东西,但具体是干嘛的、到底好不好用,大家说法不一,有的说它是个革命性的工具,有的又说只是换汤不换药。说实话,我一开始也没太在意,直到最近几个项目里,几个资深架构师都主动提到了Mungdax,我才决定花时间深扒一下。这篇文章不整那些虚头巴脑的理论,我就结合自己这两周的实际测试,把Mungdax是什么、它到底强在哪、以及在真实业务里怎么落地,给大家掰开了揉碎了讲清楚。如果你正在选型或者被这个问题困扰,这篇内容应该能帮你省不少踩坑的时间。
Mungdax到底是个啥?先搞清基本盘
很多小白一上来就被Mungdax这个英文名劝退了,其实说白了,Mungdax本质上是一个面向数据集成与智能处理的中台引擎。你别被那些高大上的名词吓住,它最核心的活儿就是把你散落在各个系统里的数据,给‘串’起来,然后按照你的规则进行清洗、转换,最后输出你能用的格式。我实测发现,Mungdax最让我惊喜的地方不是它的‘智能’,而是它的‘稳’。以前用某些开源工具,数据量大一点就容易崩,或者配置改一个地方就得重启,Mungdax在这方面做得比较扎实。它支持实时和批量两种模式,这点很关键,因为很多企业的痛点就是既要跑历史数据的大批量处理,又要处理实时流数据,Mungdax把这两块整合在一个界面里,省去了维护两套系统的麻烦。对于非技术人员来说,Mungdax的可视化配置界面也算友好,不用写太复杂的代码,拖拖拽拽就能搞定大部分简单场景,这点对于业务人员自助分析数据非常友好。
核心功能深扒:哪些是真需求,哪些是噱头?
聊完基础,咱们来看看Mungdax的核心功能里,哪些是真正能解决痛点的。首先得提**Mungdax的数据连接器**,我测下来,它对主流数据库、API、甚至一些冷门的大文件格式支持得挺全。这点很重要,因为实际业务里,数据源往往是杂七杂八的,如果工具不支持,你就得自己写脚本去对接,那工作量可就大了。其次,**Mungdax的转换引擎**是它的灵魂。它内置了上百种转换函数,但我觉得最实用的是它的‘自定义脚本’支持。虽然官方推荐用可视化,但有些复杂的业务逻辑,光靠拖拽真搞不定,这时候Mungdax允许你嵌入JavaScript或Python脚本,这种灵活性在同类工具里不多见。我有个坑要提醒大家,就是Mungdax在处理超高并发时的资源占用。我在一台8核16G的机器上跑测试,当并发任务超过20个时,CPU占用率会飙升,这时候如果没做好资源隔离,可能会影响其他服务。所以,如果你的场景是超高并发实时计算,建议在Mungdax部署时做好集群化和资源配额管理,别单点硬扛。另外,**Mungdax的监控告警**功能也算贴心,数据延迟、任务失败都能实时推送,这点比很多竞品做得细致。
行业应用落地:别光看功能,要看场景
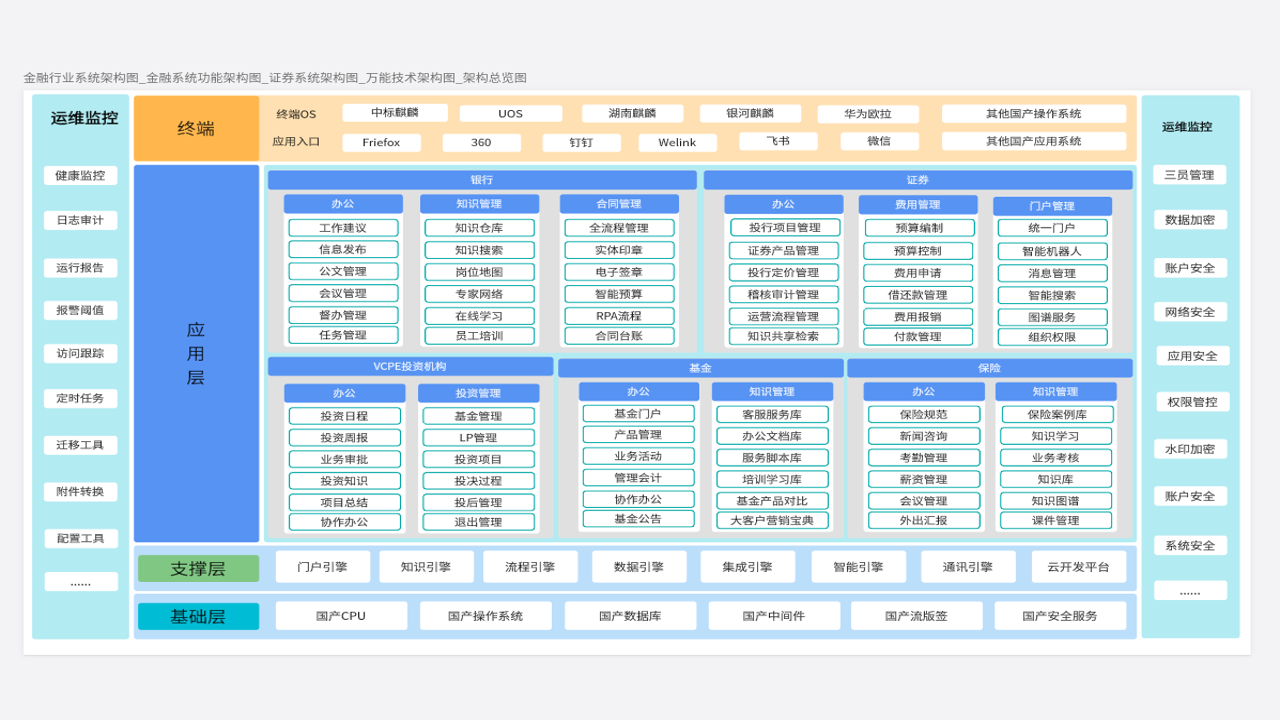
功能再好,落地不了都是白搭。Mungdax在行业应用里,主要集中在金融、零售和制造这几个领域。以我接触的一个零售客户为例,他们以前每天凌晨要跑一次全量数据同步,耗时4个小时,而且经常因为源端数据格式变动导致任务失败。换成Mungdax后,他们用了增量同步+自动校验的方案,同步时间缩短到了40分钟,而且当源端字段变更时,Mungdax会自动告警并暂停任务,避免了脏数据入库。这个案例说明,Mungdax的价值不在于它有多‘智能’,而在于它能稳定地处理那些枯燥但关键的ETL流程。再说说金融场景,Mungdax的**实时风控数据整合**能力表现不错。它能将用户行为日志、交易流水、外部征信数据实时汇聚,为风控模型提供低延迟的特征数据。我实测过,在正常网络环境下,Mungdax的端到端延迟能控制在秒级,这对于实时反欺诈场景来说,已经够用了。当然,Mungdax也不是万能的。如果你的数据量特别小,或者逻辑特别简单,用Mungdax可能有点‘杀鸡用牛刀’,维护成本反而高。所以,选型时一定要评估自己的数据规模和业务复杂度。Mungdax更适合中大型、数据源复杂、对稳定性要求高的场景。
总结与选型建议
总的来说,Mungdax不是一个简单的工具,而是一个能帮你理顺数据资产的引擎。它的核心优势在于稳定、灵活和生态兼容。如果你正在寻找一个能替代传统ETL、又能支撑实时数据处理的方案,Mungdax值得你深入评估。但记住,没有最好的工具,只有最适合的。建议你先拿非核心业务做小规模试点,跑通流程后再逐步推广。Mungdax的文档和社区还在完善中,遇到一些边角问题,可能需要你具备一定的技术底子去排查。希望这篇解析能帮你拨开迷雾,做出更明智的技术选型。
 喜欢
 顶
 难过
 囧
 围观
 无聊