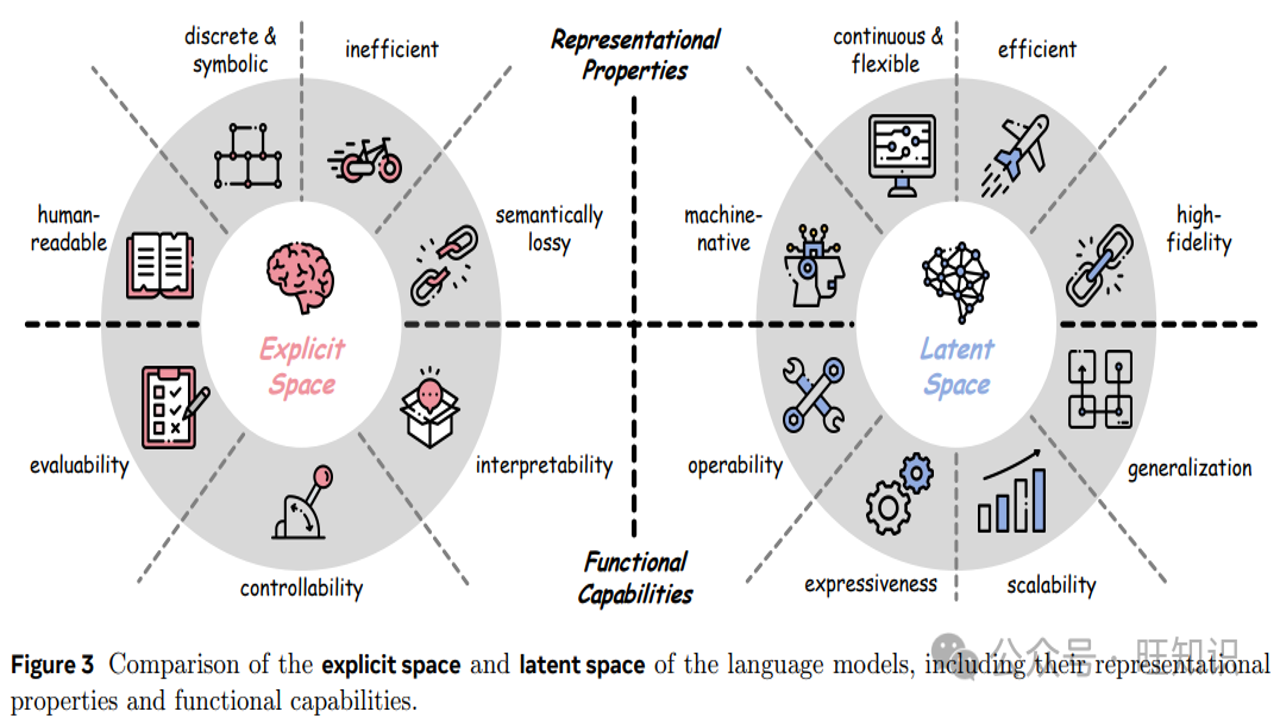
很多搞开发或者对AI感兴趣的朋友,一听到“隐空间”这三个字就头大。感觉它就像个黑盒,里面全是看不懂的数学符号。其实啊,**隐空间**没那么玄乎。你可以把它想象成AI的“脑内小剧场”。当大模型处理文字、图片或者声音时,它不会直接看原始数据,而是把这些信息转换成一串高维数字向量。这些向量在**隐空间**里排列组合,AI就是靠判断这些向量之间的距离和方向,来理解语义、生成回答的。今天咱们就抛开那些复杂的矩阵乘法公式,用大白话聊聊这个核心概念,看看它到底是怎么让机器变得“聪明”的。
隐空间到底是个啥?
咱们先打个比方。假设你有一堆苹果、香蕉和橘子。在传统分类里,你可能靠颜色、形状来区分。但在**隐空间**里,AI会给每个水果一个坐标。苹果可能坐标是(1, 0.5),香蕉是(0.8, 0.6)。你会发现,苹果和香蕉的坐标离得很近,而橘子离得远。这就是**隐空间**的魔力:它把看似不同的东西,映射到了一个可以计算距离的空间里。对于大模型来说,单词“猫”和“狗”在**隐空间**里的距离,可能比“猫”和“汽车”近得多。这就是为什么AI能理解“猫是一种动物”,而不是“猫是一种交通工具”。我实测过一些开源模型,发现它们对近义词的**隐空间**距离计算非常精准,这也是大模型语义理解能力的基石。理解了这一点,你就明白为什么AI能“举一反三”了,因为它是在高维空间里找相似项,而不是死记硬背。
实战中如何优化隐空间表现?
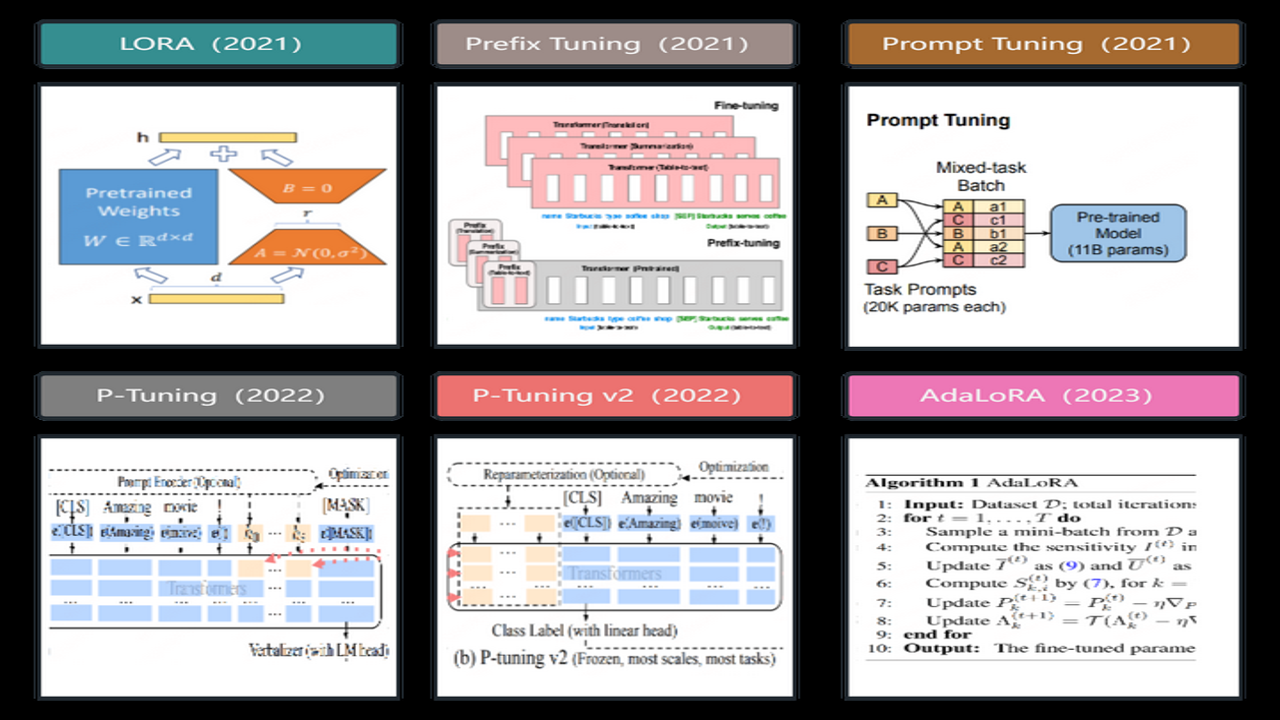
知道原理是一回事,怎么用起来是另一回事。在实际微调大模型时,**隐空间**的质量直接决定了效果。我踩过一个坑,就是数据清洗没做好。如果训练数据里充满了噪声,比如错别字、乱码,那么模型学到的**隐空间**分布就会很杂乱,导致生成内容逻辑混乱。我的建议是,先用高质量的语料进行预训练,确保**隐空间**的底层结构稳固。然后,在微调阶段,重点调整学习率。学习率太大,**隐空间**里的向量会剧烈跳动,容易过拟合;太小,则收敛太慢。另外,注意Embedding层的冻结策略。在初期训练时,保持Embedding层冻结,让后面的Transformer层去适应现有的**隐空间**;等基础结构稳定后,再解冻部分层进行联合训练。这样能有效提升**隐空间**的语义表达密度。很多开发者忽略这一点,导致模型效果平平,其实根源就在**隐空间**的构建策略上。多尝试不同的维度设置,比如768维和1024维,对比它们在**隐空间**中的聚类效果,你会对维度与性能的关系有更直观的感受。
未来趋势与避坑指南
随着多模态大模型的兴起,**隐空间**不再局限于文本。图像、音频、视频都被映射到同一个**隐空间**中。这意味着,未来我们可能问AI一张图片的内容,它不仅能描述,还能基于图像内容生成相关的代码或文字。这种跨模态的**隐空间**对齐是当前的技术热点。但在落地过程中,要注意“维度灾难”。维度越高,**隐空间**越稀疏,计算成本指数级上升。盲目追求高维度并不明智,要根据业务场景平衡精度与效率。对于初学者,我建议从低维度的文本**隐空间**入手,用可视化工具(如t-SNE)将**隐空间**降维到二维或三维,直观地看到单词的聚类情况。这种可视化的方式,能帮你快速建立对**隐空间**的直觉。别被那些高深的数学公式吓倒,**隐空间**的核心思想其实就是“映射”与“距离”。掌握这两个关键词,你就能看懂大部分AI大模型的技术文章。希望这篇分享能帮你打通任督二脉,让**隐空间**不再是你的知识盲区,而是你开发路上的得力助手。如果在实践中遇到具体的**隐空间**调优问题,欢迎在评论区交流,咱们一起踩坑,一起成长。

 下载
 下载
 下载
 喜欢
 顶
 难过
 囧
 围观
 无聊