很多刚接触编程或者处理大量中文数据的朋友,一碰到“乱码”就头大。其实这就是没搞懂**中国编码**的底层逻辑。今天咱们不整那些晦涩难懂的学术定义,就像朋友聊天一样,把GB2312、GBK、UTF-8这些名词掰开了揉碎了讲清楚。我自己踩过不少坑,比如早期从老系统导数据,一堆问号,后来才明白是编码转换没做好。这篇文章就是想把**中国编码体系**的脉络理一理,让你下次遇到类似问题能迅速定位原因,而不是在那瞎猜。
为什么我们要单独讲中国编码
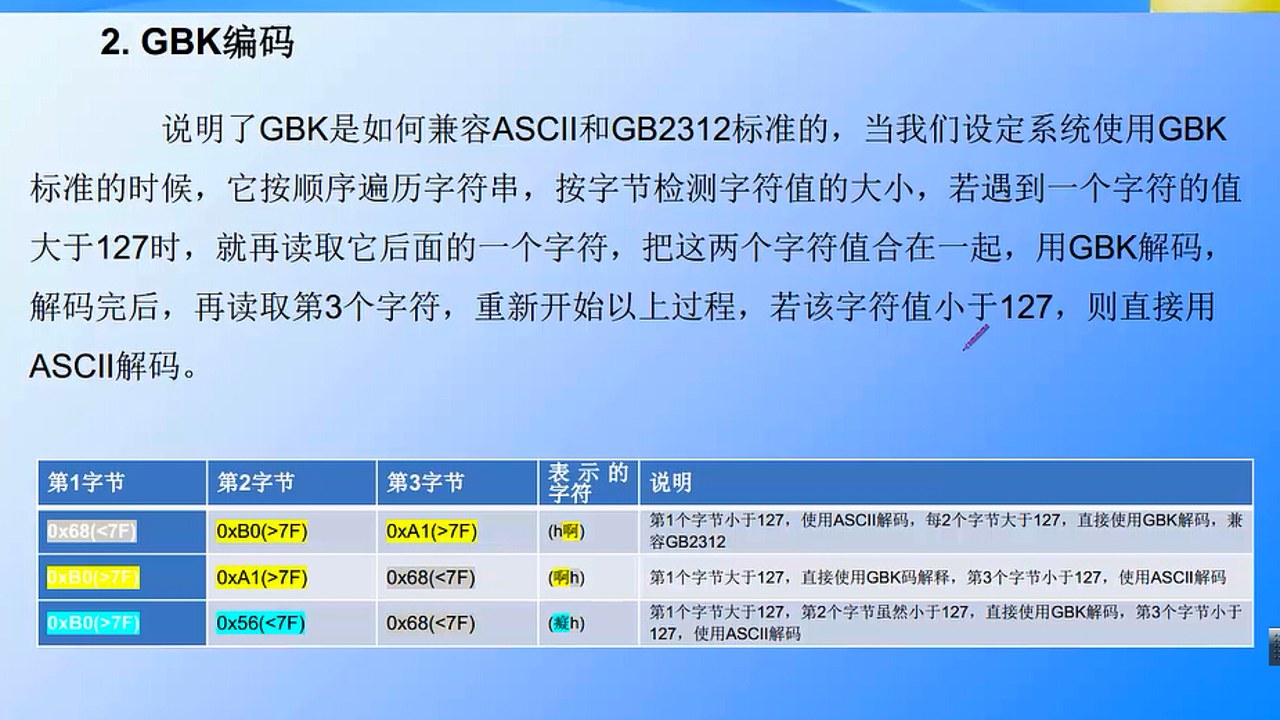
电脑里存字,本质上是存数字。但是“中”字怎么变成数字?不同国家、不同时期有一套一套的规则。咱们国家的**中国编码**标准,最早是为了让汉字能上电脑而制定的。最经典的就是GB2312,这是国家强制标准,收录了6763个常用汉字和682个符号。我当年学C语言时,老师就强调,GB2312是基础,因为它解决了“字怎么存”的问题。但问题也来了,它只收录了常用字,生僻字怎么办?这就引出了后面的GBK编码,你可以把它理解为GB2312的“加强版”,兼容了旧标准,还扩充了大量生僻字和日韩汉字。所以你在处理**中国编码**历史遗留数据时,经常会看到这两个名字混用,它们其实是继承关系,理解这一点,你就明白为什么老系统里的数据在新系统里可能显示正常,或者反过来出问题。
实际开发中怎么避坑
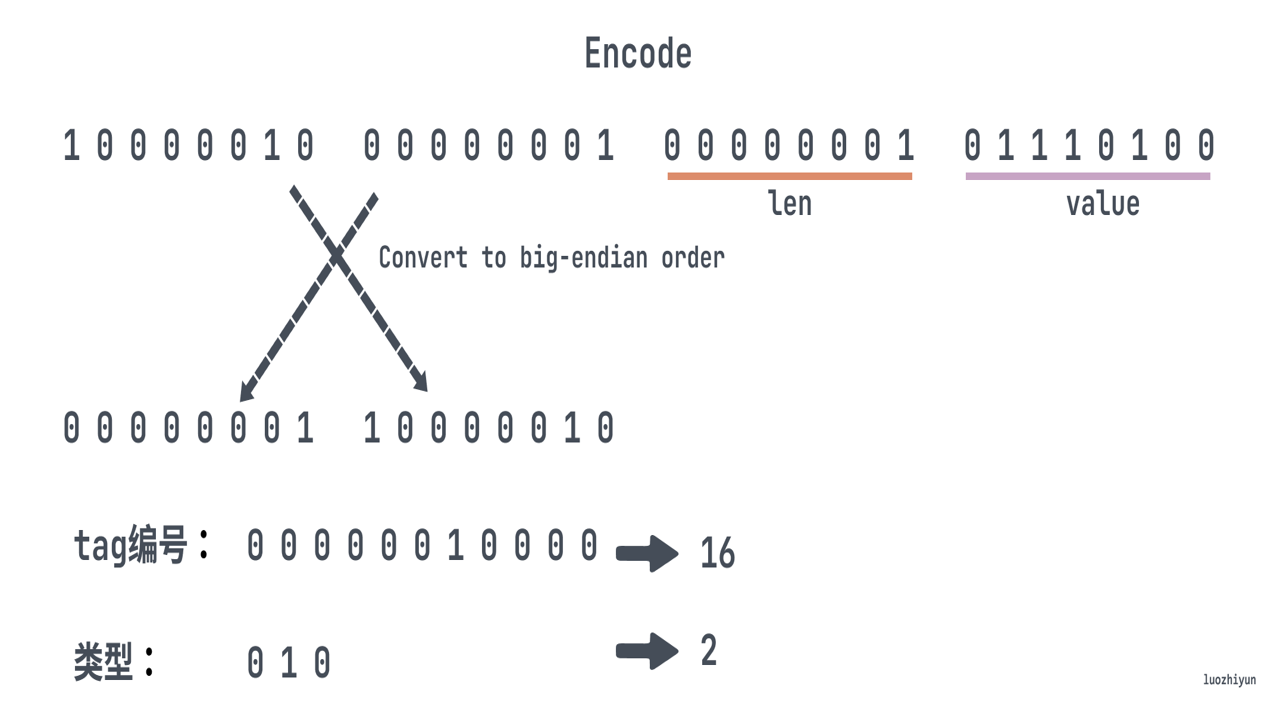
说点实在的,现在新项目基本都默认用UTF-8了,因为它国际化,支持全球字符。但在维护老项目,或者从Excel、老数据库导数据时,**中国编码**的兼容性就成了痛点。我有个朋友做财务系统,从Access导出Excel,再导入新系统,结果所有人名都变成了“???”。查了半天,发现是Excel默认用ANSI(也就是GB2312/GBK)保存,而新系统读的是UTF-8。解决办法很简单,导出时指定编码格式,或者在代码里做转换。这里有个小建议:在处理**中国编码**相关逻辑时,尽量在数据入口处统一转成UTF-8,内部传输和处理都用UTF-8,只在最后输出给用户或存到特定旧系统时再转回去。这样能减少80%的乱码问题。别觉得这是小事,我见过因为编码不一致,导致发票信息错误,最后还得人工核对的惨案。
未来趋势与个人建议
随着移动互联网和Web的普及,**中国编码**的应用场景越来越集中在后端数据处理和遗留系统维护上。对于前端开发者来说,浏览器和服务器通信基本都走UTF-8,你很少需要手动指定编码。但对于后端,特别是涉及数据库、文件读写、接口对接时,搞清楚**中国编码**体系依然至关重要。我的建议是:不要死记硬背每个编码的位宽,而是记住“兼容关系”和“适用场景”。GB2312是基础,GBK是兼容扩展,UTF-8是通用标准。遇到乱码,先查源数据的编码,再查目标系统的编码,中间加个转换层,基本都能解决。掌握这些,你就能在**中国编码**的复杂世界里游刃有余,不再被乱码困扰。
 喜欢
 顶
 难过
 囧
 围观
 无聊