做IT这行,谁还没被中文乱码坑过几次?尤其是处理老系统数据或者跨平台传输时,**中国编码** 标准就成了绕不过去的大坑。很多人以为统一用UTF-8就万事大吉了,结果一碰到古老的GB2312或者GBK,页面直接变成一堆问号。其实,**中国编码** 体系有着独特的历史背景和技术逻辑,搞不清底层原理,光靠试错太累。今天咱就抛开那些晦涩的术语,像聊天一样把 **中国编码** 的门道扒一扒,帮你彻底搞懂 **中国编码标准** 在实际项目里到底该怎么用,怎么避坑。
搞清 GB2312 和 GBK 的“爱恨情仇”
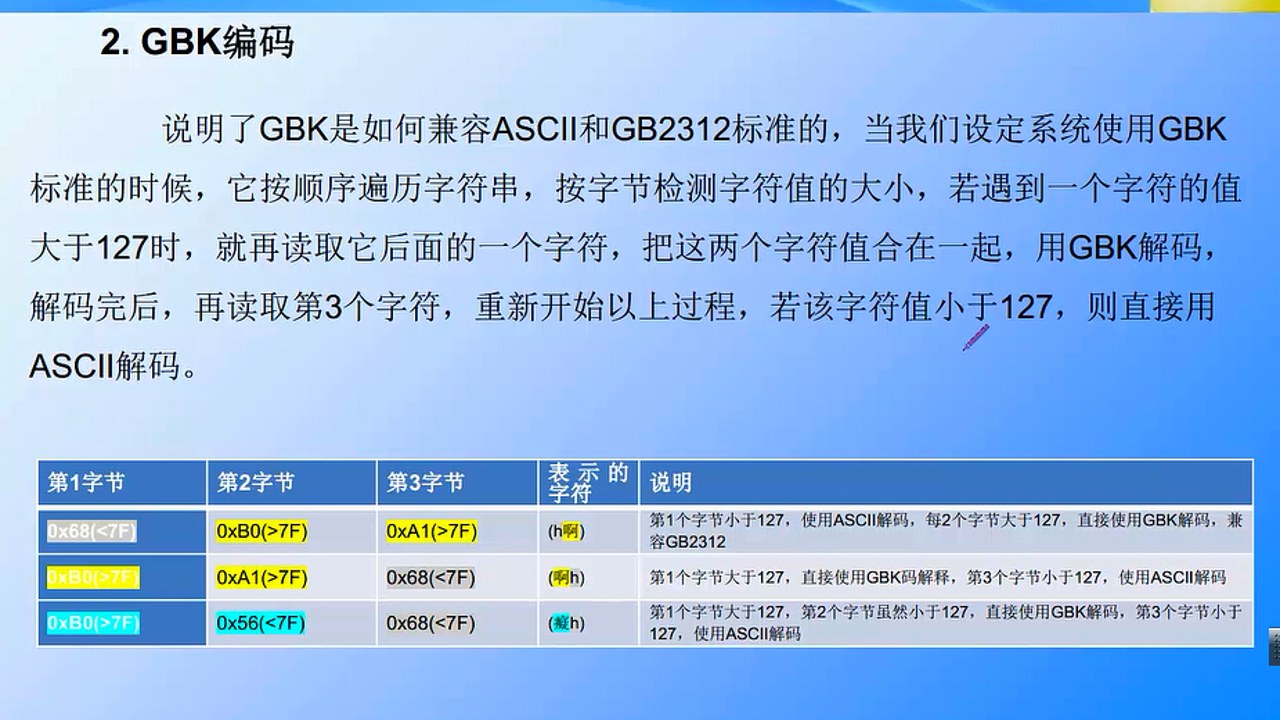
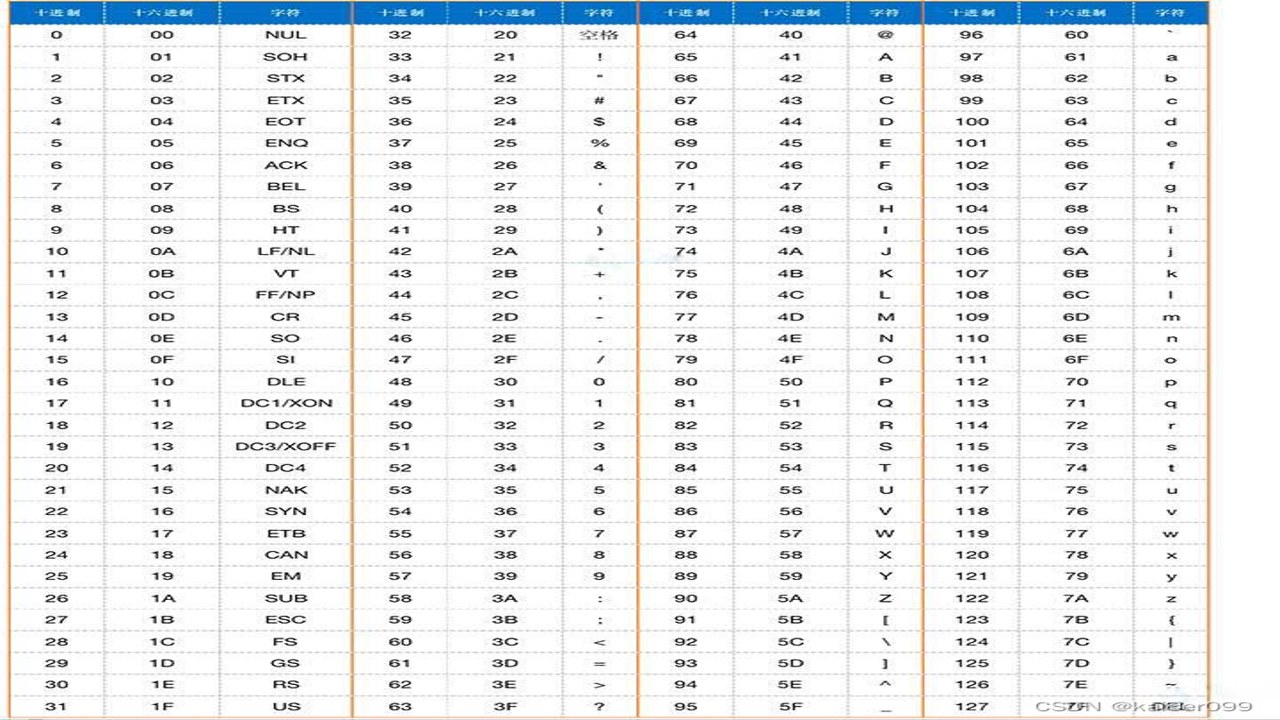
说起 **中国编码**,绕不开两个老大哥:GB2312 和 GBK。很多新手容易混淆,以为 **GB2312** 就是所有中文编码的统称,这是个误区。GB2312 其实是上世纪80年代定的标准,它只包含最常用的 6763 个汉字,覆盖面很窄。那时候电脑资源紧张,能显示常用字就不错了。但问题是,很多生僻字、繁体字在 GB2312 里根本找不到,这时候 **GBK编码** 就出场了。GBK 可以看作是 GB2312 的超集,它兼容了 GB2312,同时增加了 20000 多个汉字,基本涵盖了所有常用中文。我在维护一个老财务系统时,就因为没分清这两者,把 GBK 的数据强行按 GB2312 解析,结果一堆人名全变成了乱码,最后不得不写脚本重新转码才搞定。所以,**中国编码** 的选择,首先得看你面对的数据源是什么年代、什么标准。
UTF-8 不是万能的,兼容才是王道
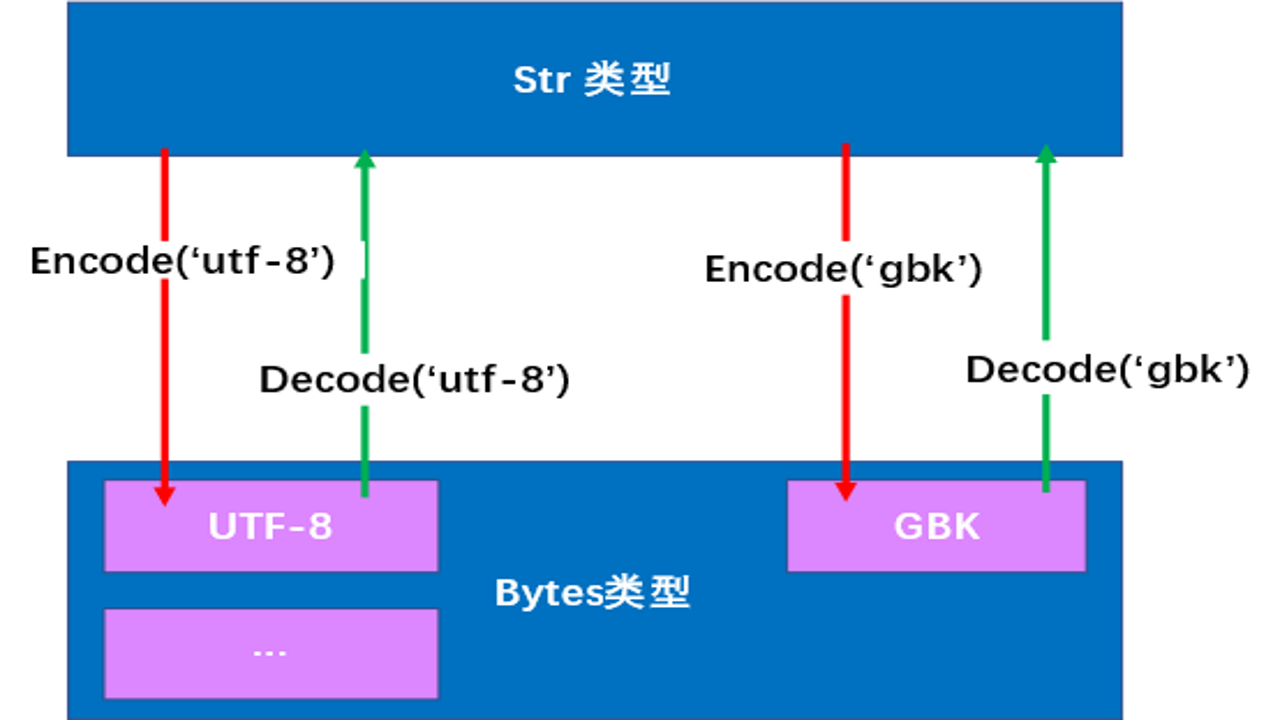
现在大家张口闭口都是 **UTF-8**,觉得它是国际标准,最先进,所以想当然地认为它可以替代所有 **中国编码** 场景。这话对了一半,错了一半。UTF-8 确实是变长编码,效率高,全球通用,但在处理 **中国编码** 时,有几个大坑。第一,UTF-8 一个汉字占 3 个字节,而 GBK 只占 2 个。在存储大量中文文本时,GBK 的空间占用更小,这对于早期的数据库和内存敏感型应用来说,是巨大的优势。第二,兼容性。很多老旧的国产软件、甚至一些政府系统的接口,底层依然是基于 GBK 的。如果你直接丢一个 UTF-8 的字符串过去,对方解码失败,直接报错。我见过一个项目,前端用 UTF-8 传参,后端老框架默认按 GBK 接收,结果中文全乱了,调试了半天才发现是编码不一致。解决 **中国编码** 冲突的关键,不在于谁更先进,而在于**通信双方必须约定同一套标准**。
实战中怎么避免“乱码”灾难
聊了这么多理论,落到实际开发中,**中国编码** 乱码往往是因为“中间商”没做对。比如从数据库取数据,数据库是 GBK,Web 服务器是 UTF-8,这时候必须在应用层做一次正确的**转码**。别以为 Java 的 `new String(bytes, "GBK")` 就万事大吉,还要看底层驱动是否支持。我在写 Python 爬虫抓取一些老网站时,发现很多页面的 meta 标签里写的是 `gb2312`,但实际内容是 **GBK**,直接按 meta 解析就会报错。这时候就得用 `chardet` 库先检测一下,或者尝试多种 **中国编码** 标准解码,直到找到正确的那个。另外,处理 Excel 文件时,CSV 格式如果不指定编码,Windows 默认是 ANSI(通常对应 GBK),Linux 默认是 UTF-8。跨平台传输时,务必在文件头加 BOM(字节序标记),或者在代码里显式指定 **encoding='utf-8-sig'**。记住,**中国编码** 问题的根源通常不是编码本身不好,而是**上下文环境不一致**。只要你在每个环节都明确指定编码,不乱猜,不乱试,90% 的乱码问题都能避免。
未来趋势:统一与兼容并存
随着技术迭代,**中国编码** 的标准也在慢慢收敛。新项目尽量统一用 UTF-8,这是大势所趋,因为它彻底解决了多语言混合的问题。但在存量系统中,**GBK** 依然有顽强的生命力。作为开发者,我们不需要成为 **中国编码** 专家,但必须成为一个“翻译官”。知道什么时候该用 GBK,什么时候该用 UTF-8,知道如何在两者之间安全地转换。这不仅是技术细节,更是一种对数据负责的态度。下次再遇到中文乱码,别急着骂娘,先检查一下 **中国编码** 链条上的每一个环节,大概率能找到问题所在。希望这篇关于 **中国编码** 的解析,能帮你省掉几个加班的夜晚。
 喜欢
 顶
 难过
 囧
 围观
 无聊