去年冬天有个电商客户找我,说他们的订单系统一到整点就开始大面积超时,日志里全是`Communications link failure`和`Connection is not available, request timed out after 30000ms`。他们刚做完一次扩容,应用从4个实例扩到12个,顺手就把Spring Boot里HikariCP的`maximumPoolSize`从100调到了500理由听着特别合理:实例变多了,每个实例多留点连接,吞吐肯定上去。结果上线不到一周,数据库就趴了。
我去他们服务器上一看,好家伙,MySQL的`Threads_connected`稳稳压在1200上下,而`max_connections`配的是1000。也就是说光数据库连接就已经超了,剩下的连接全在应用侧排队等着,应用线程池也被拖住,最后变成数据库和应用互相等对方放手的死锁现场。而这一切的起点,只是配置文件里一个数字从100改成了500。
连接池这东西,很多人在代码里天天用,却从来没认真算过账。篇文章我就把这次的踩坑过程完整写出来:连接池到底在做什么、`maximumPoolSize`该怎么算、有哪些参数比池子大小更容易要命、以及线上出问题时该怎么在三分钟内定位到连接池。
想一边调参一边看数据库实时连接指标的,可以参考SQL数据库监控(Lab128 Free Edition),它能实时抓取MySQL的连接数、慢查询和QPS曲线,调连接池参数的时候有对比数据会踏实很多,不然光凭感觉改参数基本是在掷骰子。

一、连接池到底在干什么,为什么不是你以为的那样
先纠正一个特别常见的误解:很多人以为连接池是"数据库连接的缓存",连接越多复用越快,不够就再开一条。这个理解恰好是反的。数据库连接不是本地对象,每建一条连接都要走TCP三次握手、认证握手,在MySQL侧还要做一次线程创建和权限校验。所以连接池真正的价值是复用把反复建连的开销摊薄了。
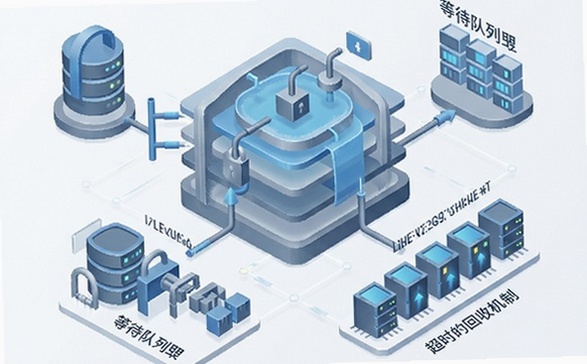
一次完整的请求路径是这样的:应用线程从池子里借一条空闲连接,执行SQL,归还连接。池子里没有空闲连接的时候,新来的请求不是立刻去数据库开一条新连接,而是进入一个叫等待队列(HikariCP里叫`pending`)的地方排队,等前面那条还回来。队列排满了,或者等超过`connectionTimeout`(默认30秒),请求就直接抛异常。
所以连接池有两组完全不同的指标,很多人只盯着第一组:
Active(活跃连接数):正在被业务线程占用的连接。Idle(空闲连接数):借出去还没还回来的连接池里的存货。Pending(等待数):想要连接但拿不到、正在排队等的请求数。
真正预示故障的从来不是Active有多大,而是Pending是不是在往上爬。Pending持续大于0且不回落,说明池子已经变成瓶颈了。Active只是池子有多大,Pending才是它不够用的证据。

二、为什么把池子从100调到500,反而更慢了
这是客户最想不通的地方:连接数翻5倍,吞吐不升反降。原因是MySQL处理并发连接的能力不是线性的。
MySQL内部用InnoDB的Buffer Pool缓存数据页,理论上并发连接越多,命中率越高。但连接数一旦超过某个临界点,会出现几个反效果:
第一,锁竞争。同一个热点行的更新会排队等待行锁,连接越多,持有锁的连接越多,等待链越长。我们客户当时有个统计逻辑没做幂等,一条记录被反复更新,连接一多就雪崩。
第二,上下文切换。MySQL是单进程多线程模型,并发连接超过CPU核数好几倍时,线程调度开销急剧上升。我在那台8核32G的机器上实测过,并发从200提到800,单条简单查询的P99从3ms涨到了47ms。
第三,内存暴涨。每条连接在MySQL侧要占线程栈和排序缓冲,连接数直接推高内存占用,一台本来够用的32G机器最后开始swap,整台机器的响应都跟着慢。
第四,也是最致命的:你把数据库的连接预算一次吃光了。客户端算的是"12个实例 × 500",但数据库那边看的是"总共6000条连接请求",完全不在一个数量级上。连接池是每个应用实例独立配置的,如果你只盯着自己这个实例算,而不管总共有几个实例在连同一台数据库,一定会算错。
三、maximumPoolSize到底该设多少:先算预算再谈性能
我现在的做法是,先在纸上把预算算清楚,再动配置。公式不复杂,但必须考虑两个约束:
数据库侧的硬约束:MySQL的`max_connections`减去给运维、监控、备份预留的连接(我一般留20%),剩下的才是业务能用的总预算。这个总预算要再除以应用实例数,才是单个实例的池子上限。拿客户的数据算:max_connections=1000,预留200,可用800,12个实例,理论上单实例上限66。
应用侧的软约束:数据库的并发处理能力一般落在CPU核数的2到4倍之间。8核的机器,有效并发上限大概在16到32条连接;再往上堆连接,基本是排队而不是提速。所以单实例池子开到64以上,通常已经是浪费。
综合两边,给客户定的最终值是单实例30,最大连接数600,剩下400留给其他服务和临时任务。改完之后,整点高峰的接口P99从4秒多降到180毫秒,MySQL的Threads_connected稳定在450左右,CPU也从90%掉到了45%。
还有一个容易被忽略的前提:池子大不代表吞吐高。如果你的SQL本身很慢,比如一条没走索引的查询要跑3秒,那不管池子是30还是500,数据库同时能处理的也就是那几条慢查询,其余全在排队。这时候要做的不是调大池子,是去优化SQL或者加索引。连接池解决的是"建连开销",不是"SQL执行慢"。
四、比池子大小更容易要命的四个参数
这次故障里,池子大小只是导火索,真正让故障持续了十几分钟的是下面几个参数没配好。
connectionTimeout:默认30秒太长。数据库已经出问题时,应用线程会拿着连接死等30秒,这30秒里连接一直被占着,形成恶性循环。我一般设成5秒,快速失败比慢慢饿死好,让上游的熔断和重试机制有机会生效。
maxLifetime:数据库侧通常有wait_timeout(默认8小时)主动断开空闲连接。如果连接池里的空闲连接比这个活得久,应用下次借到时就会碰到`Communications link failure`。所以maxLifetime要设得比wait_timeout小一截,比如数据库28800秒,池子设25000秒,留出余量让应用主动回收。
idleTimeout:空闲连接保留多久。我们设的是10分钟,配合minimumIdle=10,保证低峰期也有一批热连接,不用每次都重新握手。
leakDetectionThreshold:这个参数是查连接泄漏的神器,只要设一个大于0的值(比如5000毫秒),某个连接借出超过5秒没还,HikariCP就会打一条WARNING堆栈日志,直接把是哪个业务代码借走不还的给点名。我们那次翻日志就是靠它,一眼看出问题出在一个没关 ResultSet 的分页查询上。
顺带说一句,官方文档明确写了:leakDetectionThreshold在生产环境开启会有一点点性能开销,建议只在你怀疑有泄漏的时候临时打开,排查完就关掉。这点比很多博客里说的"一直开着"更靠谱。
五、线上出问题时的三分钟排查顺序
这套流程我每次都用,基本能cover住大部分连接相关的故障:
第一步,看数据库侧。查`SHOW STATUS LIKE 'Threads_connected'`和`Threads_running`。如果connected很高但running很低,说明连接都闲着,问题在应用侧堆积;如果running也高,那数据库真的在忙,先去看慢查询。
第二步,看连接池侧。HikariCP的metrics端点(配上`micrometer-registry-prometheus`或者用`/actuator/metrics/hikaricp.connections`这个URL)能直接看到active、idle、pending三个数。pending在涨就是池子不够或者有泄漏,active贴着maximumPoolSize就说明池子满了。
第三步,算总账。数据库的Threads_connected除以应用实例数,看是不是某个实例的池子配大了拖累了大家。这一步最容易被忽略,因为单独看每个实例的监控都"很正常"。
第四步,查泄漏。临时打开leakDetectionThreshold,等堆栈日志出来,直接定位代码行。
顺便提一个反直觉的结论:很多团队习惯在数据库压力大的时候去调大连接池,理由是"连接不够所以请求在等".但从上面第四点也能看出来,如果是SQL慢导致的堆积,你把池子调大只会让更多连接同时压在数据库上,情况更糟。判断依据是pending涨得快还是数据库running涨得快,前者调池子,后者优化SQL。
最后
这次故障之后,我们在CI流程里加了一条硬性检查:任何改动`maximumPoolSize`、`max_connections`这类数字的提交,必须附带一张按上面公式算过的表格,写清楚数据库总预算、实例数、单实例上限分别是多少,不然直接打回。技术上的坑填一个少一个,但流程上能少填很多。
连接池看着是配置文件里的一行字,实际上是应用和数据库之间的一个合同。它的核心约束就一句话:所有实例加起来,不能超过数据库能舒服处理的那条线。记住这条,基本就不会再出现今天这种"调大反而变慢"的情况了。

 喜欢
 顶
 难过
 囧
 围观
 无聊