上周三凌晨两点多,我被一通电话叫醒。客户的行情接口页面打不开了,打开开发者后台一看,某个查询接口过去一小时接收了3万多次请求,而这个接口正常情况下一天也就几百次。数据库连接池被瞬间打满,CPU跑满,后面所有正常用户的请求全部排队超时。我第一反应是加机器,但拦下来一看,那3万次请求全部来自同一个IP段,而且是规规矩矩地按固定频率打过来的,这是典型的脚本刷接口,不是正常用户洪峰。
机器扩容只能挡住一部分流量,真正对症的做法是在流量进到应用之前就把它掐住。我在客户服务器的Nginx里加了一层令牌桶限流,不到二十分钟,这个接口的实时QPS从8000多压回到200以内,页面立刻就恢复了。这篇把我用的配置、每个参数的含义,以及中间踩过的六个坑完整记录下来,你可以照着改自己的Nginx配置。
想自己搭一套Nginx防护的,可以参考Nginx v1.27.1官方稳定版,官方编译的版本本身就自带了limit_req这个模块,不需要额外装第三方模块,编译时加个--with-http_limit_req_module参数就行,大部分发行版的软件源里的包已经默认带上了。
一、先说清楚:令牌桶到底是怎么限的
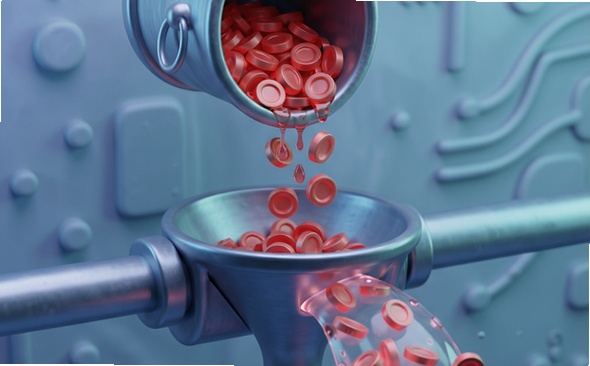
限流有两套模型,漏桶(Leaky Bucket)和令牌桶(Token Bucket),Nginx的limit_req用的是令牌桶。区别其实很直观:漏桶是固定速率往外滴水,多出来的请求只能排队等着;令牌桶是往桶里按固定速率放令牌,请求来了要先拿到一个令牌才能通行,桶里没令牌就直接拒绝。
这意味着令牌桶允许一定程度的突发。桶里有存量令牌的时候,请求可以短时间冲得比平均速率高,冲完就回到平均速率上限。这个特性对正常业务特别重要,比如整点时有个流量尖峰,或者定时任务集中拉一次数据,如果用死板的漏桶,这些合法突发也会被误杀,而令牌桶允许它们在额度内通过。
Nginx实现的是简化版令牌桶,参数就那几个,但每一个都能踩坑,我下面挨个说。
二、我的最终配置,四个参数逐个拆
先看代码。这段放在http块里,定义限流区域:
limit_req_zone $binary_remote_addr zone=api_limit:10m rate=200r/s;
然后在server或location里引用:
location /api/ { limit_req zone=api_limit burst=100 nodelay; proxy_pass http://backend; }
四个关键参数,一个一个说清楚:
rate=200r/s 是基准速率,意思是每个客户端IP每秒可以拿到200个令牌。这是最重要的一个参数,设多少取决于你后端应用能扛住多少并发。设高了等于没设,设低了正常用户也会被误伤。我这次是看客户端接口的实际瓶颈定的200。
burst=100 是桶的容量,也就是允许的突发额度。桶里最多能攒100个令牌,攒满了新来的请求就得等。理解成:短时间内允许超出rate的部分,最多冲到100。
nodelay 是我最推荐加上的一个。它决定突发请求要不要排队等令牌。不加的话,突发请求会进队列慢慢一个个放行,客户端感觉是"卡住了";加上之后,桶里有令牌就直接放行,没有就立刻返回503,不拖延。所以我这里是直接拒,让客户端自己重试,反正刷接口的脚本也没打算给你好脸色。
zone=api_limit:10m 是共享内存区大小,10m能存大约16万个IP的状态。太小会报错"the shared memory zone is too small",too many keys"。如果你的站点面向公网、来路很杂,建议至少给10m,机器内存宽裕的给20m也不过分。
至于$binary_remote_addr,它是用客户端IP的前三段做键,相当于给整个C段共享一个桶。这个设计有争议:好处是能防住同一网段的小规模分布式刷量,坏处是同一个公司出口IP后面的所有人会互相挤占额度。我的场景是公网行情接口,同C段的用户不算多,所以我保留了这个配置。如果你的站点用户集中在几个大公司出口,建议换成$http_x_forwarded_for配合map模块,或者干脆用$remote_addr保证隔离。
三、限了却没生效?这六个坑我全踩过
坑一:只配了zone忘了在location里引用。 limit_req_zone只是定义了区域,必须要有limit_req zone=xxx那句真正生效。这个错误很隐蔽,因为Nginx -t 测试是通过的,启动也没有任何报错,但流量就是没被限。我在客户的配置里就发现过limit_req_zone写好了,location里压根没有limit_req。
坑二:反向代理后面拿到的IP全是Nginx自己。 如果Nginx在CDN后面或者做了多层代理,$remote_addr拿到的是上一层代理的IP,全站共用一个桶,一个正常用户就能把所有额度吃光。这时候必须配real_ip_header和set_real_ip_from,把真实客户端IP透传出来。这个坑最隐蔽,表现为"限流一上线全站都变慢",但实际上只有一个IP在吃额度。
坑三:burst和nodelay没配,突发被默默排队。 不配nodelay的时候,客户端的体验是延迟增加而不是报错,很多人会误以为是网络问题,查半天查不到限流头上。
坑四:返回503,但前端没做重试。 限流触发时Nginx返回的是503 Service Temporarily Unavailable。如果你的前端把503直接弹给用户,那正常用户在高峰期也会看到错误页面。更合理的做法是用limit_req_status指令改成429 Too Many Requests,语义上更准确,前端也好识别重试。我这次就改成了429。
坑五:多层反向代理时,内层Nginx又限了一遍。 如果架构是CDN → 外层Nginx → 内层Nginx,两层都配了限流,实际阈值会相乘式地变严,限流效果远超预期。我在排查的时候还以为是限流参数写大了,最后发现是两层都在限。
坑六:没有配套的监控,限流开了也不知道。 限流一定会误伤一部分正常用户,比例多少、哪些接口被限得最多,这些数据必须能看到。我现在的做法是同时开一个limit_req_status日志,把被拒的请求单独记录下来,配合awk统计一下每分钟被限的IP数量,超过阈值就告警。
四、限流之后还得做的事
限流只是止血,不是治病。这次处理完我给客户补了三件事:第一,给那个高频接口加了登录鉴权,原来是个无鉴权的开放接口,谁都能调,这才是被刷的根本原因;第二,接口加了一层缓存,同样的查询参数在30秒内直接返回内存里的结果,连数据库都省了;第三,把返回数据里那些没用的字段砍掉,原本一个请求返回40多个字段,精简到12个,响应体小了一半。
做完这三件事之后,那个接口的日常QPS从8000降到了200左右,比限流之前还稳。我一直觉得,限流是给不靠谱的系统打的补丁,不该是常态手段。真正该做的是让正常用户的请求足够便宜,让恶意请求的成本足够高。
如果你也在用Nginx做反向代理,建议现在就打开limit_req模块试一下,不用先等到被刷的那天。配的时候参数保守一点,rate先按你后端实测能力的30%来设,burst给个几十到一百,加上nodelay和429状态码,观察一周再调。反过来,如果你的站点现在完全没有限流,那它现在能跑,只是运气还没用完。

 喜欢
 顶
 难过
 囧
 围观
 无聊